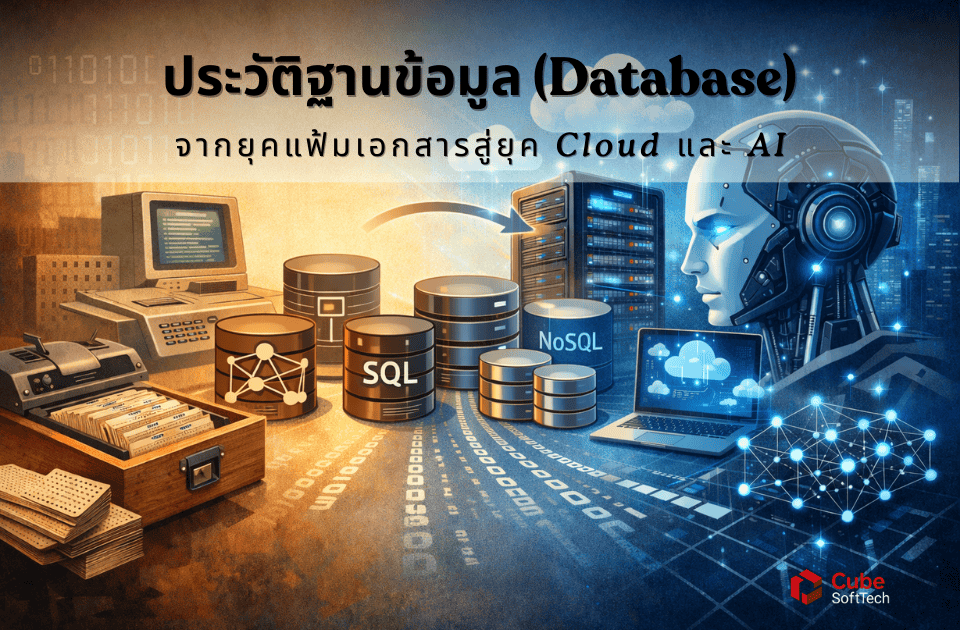
ประวัติฐานข้อมูล (Database): จากยุคแฟ้มเอกสารสู่ยุค Cloud และ AI


 Copied
link!
พาย้อนเส้นทางวิวัฒนาการของฐานข้อมูลแบบอ่านเข้าใจ ตั้งแต่ก่อนมี Database จนถึงยุค Lakehouse และ Vector Database ที่ขับเคลื่อนงาน AI ในปัจจุบัน
สารบัญ
- Introduction: ทำไมฐานข้อมูลถึงเป็นหัวใจโลกดิจิทัล
- ยุค 0: ก่อนมีฐานข้อมูล — แฟ้มเอกสารและไฟล์กระจัดกระจาย
- ยุค 1: ฐานข้อมูลยุคแรก — Batch และ Mainframe
- ยุค 2: Hierarchical Database — โครงสร้างต้นไม้
- ยุค 3: Network Database — โครงสร้างใยแมงมุม
- ยุค 4: Relational Database — ตารางและ SQL เปลี่ยนโลก
- ยุค 5: Client–Server & เว็บ — ความเร็วและความทนทาน
- ยุค 6: Big Data & NoSQL — โลกที่ไม่ใช่แค่ตาราง
- ยุค 7: Cloud-Native — Database as a Service
- ยุค 8: ปัจจุบัน — Lakehouse, Real-time และ Vector DB
- ตารางสรุปวิวัฒนาการ
- Conclusion + คำถามชวนคิด
- FAQ
- Meta / Keywords / Hashtags / Permalink
ทำไม “ฐานข้อมูล” ถึงเป็นหัวใจของโลกดิจิทัล
ลองนึกภาพชีวิตประจำวันหนึ่งวันของเรา ตั้งแต่ตื่นมาเช็กแชต สั่งอาหาร โอนเงิน จองคิวโรงพยาบาล ไปจนถึงดูซีรีส์ ทุกอย่างมี “ข้อมูล” อยู่เบื้องหลัง และข้อมูลเหล่านั้นไม่ได้กระจัดกระจายแบบไร้ระเบียบ แต่ถูกจัดเก็บให้ค้นหาได้เร็ว อัปเดตได้ถูกต้อง และเชื่อถือได้ สิ่งที่ทำหน้าที่นี้ก็คือ Database (ฐานข้อมูล)
คำว่า “ฐานข้อมูล” ฟังดูเหมือนเป็นเรื่องของคนไอทีเท่านั้น แต่จริง ๆ แล้วมันคือ “ระบบความทรงจำ” ขององค์กรและบริการดิจิทัลทั้งหมด ถ้าฐานข้อมูลทำงานไม่ดี เราจะเจอปัญหาแบบที่คุ้น ๆ เช่น
- กดสั่งของแล้วสถานะไม่อัปเดต หรือขึ้นซ้ำ
- โอนเงินแล้วเงินหายไปช่วงหนึ่ง (เพราะข้อมูลไม่ตรงกัน)
- ระบบล่ม เพราะคนใช้งานพร้อมกันเยอะ
- ค้นหาข้อมูลช้า เหมือนเปิดแฟ้มเอกสารทีละเล่ม
บทความนี้จะพาคุณย้อนดูว่า ฐานข้อมูลเริ่มต้นมาอย่างไร ผ่านแต่ละ “ยุค” ที่เปลี่ยนโลก ตั้งแต่ยุคบัตรเจาะรูและแฟ้มเอกสาร ไปจนถึงยุค Cloud และ AI ในปัจจุบัน พร้อมอธิบายแบบอ่านเข้าใจ ไม่ต้องมีพื้นฐานมาก่อน
เป้าหมายคืออ่านจบแล้วคุณจะเห็นภาพว่า “ทำไมฐานข้อมูลถึงวิวัฒนาการ” ไม่ใช่แค่จำชื่อเทคโนโลยี
ยุค 0: ก่อนมีฐานข้อมูล — โลกของแฟ้มเอกสารและไฟล์กระจัดกระจาย
ก่อนที่คำว่า Database จะเป็นเรื่องปกติ องค์กรจำนวนมากเก็บข้อมูลในรูปแบบที่เรียกว่า File-based system หรือระบบที่เก็บข้อมูลแยกเป็นไฟล์ตามแผนก/ตามโปรแกรม เช่น บัญชีมีไฟล์ลูกหนี้ของตัวเอง ฝ่ายขายมีไฟล์ลูกค้าอีกชุด คลังมีไฟล์สินค้าอีกชุด
ปัญหาหลักของระบบไฟล์
- ข้อมูลซ้ำ (Data redundancy): ลูกค้าคนเดียวมีหลายไฟล์ พอแก้เบอร์โทรต้องแก้หลายที่
- ข้อมูลไม่ตรงกัน (Inconsistency): แผนกหนึ่งอัปเดตแล้ว แต่อีกแผนกยังเป็นข้อมูลเก่า
- ค้นหา/รวมข้อมูลยาก: อยากรู้ยอดขายรวมทั้งปี ต้องดึงหลายไฟล์มารวมกันเอง
- ความปลอดภัยจัดการยาก: ไฟล์กระจายอยู่หลายเครื่อง หลายคนเข้าถึงได้ง่ายเกินไป
ถ้าเปรียบเทียบให้เห็นภาพ ระบบไฟล์เหมือน “บ้านที่เก็บของไว้ทุกห้องแบบไม่มีตู้กลาง” ของอยู่ครบ แต่หาของยาก และเสี่ยงหาย
สิ่งนี้เป็นแรงผลักดันให้เกิดแนวคิดว่า เราควรมีที่เก็บข้อมูลกลาง ที่หลายโปรแกรมใช้งานร่วมกันได้ และมีคนคุมกติกาให้เป็นระเบียบ
ยุค 1: ฐานข้อมูลยุคแรก — บัตรเจาะรูและ Mainframe
ย้อนกลับไปในช่วงที่คอมพิวเตอร์ยังเป็นเครื่องใหญ่ ๆ ราคาแพง องค์กรใช้คอมพิวเตอร์เพื่อประมวลผลรายการซ้ำ ๆ เช่น เงินเดือน สต็อกสินค้า หรือทะเบียนลูกค้า
ในยุคนี้การทำงานมักเป็นแบบ Batch processing คือรวบรวมข้อมูลไว้แล้วค่อยประมวลผลทีเดียวเป็นรอบ ๆ (ยังไม่เรียลไทม์)
- พนักงานป้อนข้อมูลเป็นชุด
- ระบบรันกลางคืน
- เช้ามาได้ผลลัพธ์เป็นรายงาน
นี่เป็นจุดเริ่มต้นของแนวคิด “ข้อมูลต้องถูกจัดเก็บอย่างเป็นระบบ” แม้จะยังไม่ใช่ Database แบบที่เราคุ้นเคย
ยุค 2: ฐานข้อมูลแบบลำดับชั้น (Hierarchical Database) — โครงสร้างแบบต้นไม้
เมื่อองค์กรเริ่มมีข้อมูลมากขึ้น จึงเกิดฐานข้อมูลแบบ Hierarchical ที่จัดข้อมูลเป็นโครงสร้างเหมือน “แผนผังต้นไม้”
แนวคิดหลัก
- ความสัมพันธ์แบบ พ่อ-ลูก (Parent–Child)
- หนึ่งพ่อมีลูกหลายคนได้
- แต่ลูกหนึ่งคนมีพ่อได้แค่คนเดียว
เหมาะกับอะไร
ข้อมูลที่มีโครงสร้างชัด เช่น ข้อมูลพนักงาน → แผนก → บริษัท หรือรายการสินค้า → หมวดหมู่ → แผนก
ข้อจำกัดที่ทำให้ต้องไปต่อ
- ถ้าต้องการความสัมพันธ์แบบ “หลายต่อหลาย” จะลำบาก
- การเปลี่ยนโครงสร้างข้อมูลทำได้ยาก (เหมือนปรับผังต้นไม้ทั้งสวน)
ยุค 3: ฐานข้อมูลแบบเครือข่าย (Network Database) — เชื่อมโยงแบบใยแมงมุม
เพื่อแก้ข้อจำกัดของแบบต้นไม้ จึงเกิดฐานข้อมูลแบบ Network ที่อนุญาตให้ข้อมูลเชื่อมกันได้หลายทางมากขึ้น
แนวคิดหลัก
- หนึ่งรายการเชื่อมกับหลายรายการได้
- รองรับความสัมพันธ์แบบหลายต่อหลาย (Many-to-many)
แต่ทำไมไม่เป็นที่นิยมในระยะยาว
- โครงสร้างและการเขียนโปรแกรมซับซ้อน
- ต้องรู้ “เส้นทาง” การเข้าถึงข้อมูลชัดเจน (เหมือนต้องจำทางเดินในเขาวงกต)
Network DB คือก้าวสำคัญที่ทำให้โลกเห็นว่า “ความสัมพันธ์ของข้อมูล” คือเรื่องใหญ่ แต่ความซับซ้อนนี้เองทำให้วงการเริ่มมองหาแนวทางที่ใช้งานง่ายกว่า
ยุค 4: ฐานข้อมูลเชิงสัมพันธ์ (Relational Database) — ตารางที่เปลี่ยนโลก
ฐานข้อมูลที่ส่งผลต่อโลกไอทีอย่างมากคือ Relational Database (RDBMS) ซึ่งทำให้ฐานข้อมูล “เข้าถึงได้ง่ายขึ้น” และกลายเป็นมาตรฐานขององค์กรจำนวนมาก
แนวคิดที่ทำให้มันปัง
Relational DB จัดข้อมูลเป็น ตาราง (Table) เหมือนสเปรดชีต
- แถว (Row): ข้อมูลหนึ่งรายการ เช่น ลูกค้า 1 คน
- คอลัมน์ (Column): คุณสมบัติ เช่น ชื่อ เบอร์โทร อีเมล
และที่สำคัญคือ “ความสัมพันธ์” ระหว่างตาราง ทำได้ผ่านคีย์ เช่น CustomerID
SQL: ภาษาที่ทำให้คนคุยกับฐานข้อมูลได้ง่าย
จุดเด่นของ SQL คือคุณบอกระบบว่า “อยากได้อะไร” โดยไม่ต้องบอกละเอียดว่า “จะไปเอายังไง” เช่น อยากได้รายชื่อลูกค้าที่ซื้อสินค้ากลุ่ม A หรือยอดขายรวมรายเดือน
ทำไมธุรกิจชอบ Relational DB
- ความถูกต้องของธุรกรรม (Transaction): เช่น โอนเงินต้องไม่หาย ไม่ซ้ำ
- มีมาตรฐานชัด: ใช้ SQL ใกล้เคียงกันได้หลายระบบ
- เหมาะกับงานองค์กร: บัญชี สต็อก ออเดอร์ CRM
ข้อจำกัดเริ่มชัดเมื่อโลกโตขึ้น
เมื่ออินเทอร์เน็ตและแอปพลิเคชันโตแบบก้าวกระโดด RDBMS เริ่มเจอความท้าทาย เช่น ข้อมูลมหาศาลและหลากหลาย รวมถึงการขยายแบบกระจายหลายเครื่อง (distributed) ที่ซับซ้อนขึ้นในบางเคส
ยุค 5: Client–Server และยุคเว็บ — ฐานข้อมูลกลายเป็นหัวใจบริการออนไลน์
เมื่อระบบเริ่มมีผู้ใช้จำนวนมากพร้อมกัน ฐานข้อมูลต้องรองรับสิ่งที่ยุคก่อน ๆ เจอน้อยกว่า เช่น ผู้ใช้พร้อมกันจำนวนมาก (Concurrency) ความเร็วในการตอบสนอง (Latency) และความน่าเชื่อถือของระบบ
Index: ทำให้ค้นหาเร็วเหมือนมีสารบัญ
ถ้าตารางข้อมูลใหญ่ขึ้น การค้นหาแบบไล่ทีละแถวจะช้า การทำ Index เปรียบเหมือนทำสารบัญหนังสือ ทำให้กระโดดไปหน้าที่ต้องการได้ทันที
Replication & Failover: ทำให้ระบบไม่ล่มง่าย
- Replication: ทำสำเนาฐานข้อมูลไปอีกเครื่อง
- Failover: ถ้าเครื่องหลักล่ม ให้เครื่องสำรองขึ้นมาทำงานแทน
สิ่งเหล่านี้เป็นพื้นฐานของความน่าเชื่อถือที่เรา “คาดหวังโดยอัตโนมัติ” ในยุคดิจิทัล
ยุค 6: Big Data และ NoSQL — เมื่อโลกไม่ได้มีแค่ข้อมูลแบบตาราง
พอเข้าสู่ยุคโซเชียลมีเดีย สมาร์ตโฟน และบริการออนไลน์ขนาดใหญ่ เราเริ่มสร้างข้อมูลที่ไม่เป็นตารางสวย ๆ มากขึ้น เช่น โพสต์ ข้อความ คอมเมนต์ รูป วิดีโอ และล็อกการใช้งานจำนวนมหาศาล
NoSQL ไม่ได้แปลว่า “ไม่ใช้ SQL เลย” แต่หมายถึงฐานข้อมูลที่ไม่ยึดรูปแบบตารางแบบเดิมเป็นหลัก
NoSQL หลัก ๆ มีแบบไหน และเหมาะกับอะไร
Key–Value เหมาะกับแคช/เซสชัน Document เหมาะกับข้อมูลยืดหยุ่น (เช่น JSON) Column-family เหมาะกับสเกลใหญ่แบบกระจาย Graph เหมาะกับความสัมพันธ์ซับซ้อน
จุดเปลี่ยนสำคัญของยุค NoSQL
หลายระบบ NoSQL เน้นการ “ขยายด้วยการเพิ่มเครื่อง” (Scale-out) และอาจยอมแลกบางอย่าง เช่น ความสอดคล้องของข้อมูลแบบทันทีในทุกจุด เพื่อให้ระบบใหญ่ขึ้นและทนทานขึ้น
ยุค 7: Cloud-Native Database — ฐานข้อมูลกลายเป็นบริการ (Database as a Service)
เมื่อ Cloud กลายเป็นโครงสร้างพื้นฐานหลัก ฐานข้อมูลก็เปลี่ยนบทบาทจาก “ของที่ต้องติดตั้งเอง” ไปเป็น “บริการที่พร้อมใช้”
สิ่งที่ Cloud เปลี่ยนเกม
- Provision ง่าย: สร้างฐานข้อมูลได้ในไม่กี่นาที
- ขยายได้ตามใช้จริง: ช่วงโปรโมชันคนเยอะก็เพิ่มทรัพยากรได้
- HA/Backup อัตโนมัติ: ลดภาระทีมดูแลระบบ
สำหรับองค์กรจำนวนมาก นี่คือการเปลี่ยนจาก “ดูแลเครื่อง” ไปเป็น “ดูแลข้อมูลและการใช้งาน”
ยุค 8: ยุคปัจจุบัน — Data Platform, Lakehouse และฐานข้อมูลเพื่อ AI
ปัจจุบันคำว่า “ฐานข้อมูล” ไม่ได้หมายถึงที่เก็บธุรกรรมอย่างเดียว แต่รวมถึงแพลตฟอร์มข้อมูลทั้งชุด
1) Data Warehouse / Data Lake / Lakehouse
- Data Warehouse: เน้นข้อมูลที่จัดรูปแบบดีเพื่อทำรายงาน
- Data Lake: เน้นเก็บข้อมูลดิบได้หลากหลาย
- Lakehouse: พยายามรวมข้อดีของสองโลกเข้าด้วยกัน
2) Real-time Analytics
โลกธุรกิจอยากเห็นข้อมูล “ตอนนี้” ไม่ใช่รอพรุ่งนี้ เช่น แดชบอร์ดยอดขายแบบเรียลไทม์ หรือการตรวจจับการทุจริตทันที
3) Vector Database: เมื่อ AI ต้อง “ค้นหาความหมาย” ไม่ใช่แค่คำ
ยุค GenAI ทำให้เกิดโจทย์ใหม่: เราต้องเก็บข้อมูลในรูปแบบที่ค้นหา “ความใกล้เคียงของความหมาย” ได้ เช่น ค้นหาข้อความที่ความหมายคล้ายกัน เพื่อทำระบบถามตอบกับเอกสารองค์กร และช่วยให้ AI ดึงข้อมูลอ้างอิงได้ดีขึ้น
ตารางสรุป: วิวัฒนาการฐานข้อมูลแบบเร็ว ๆ
| ยุค | แนวคิดหลัก | จุดเด่น | ข้อจำกัดที่ทำให้เกิดยุคถัดไป |
|---|---|---|---|
| ระบบไฟล์ | เก็บข้อมูลแยกตามไฟล์ | ง่าย เริ่มต้นไว | ข้อมูลซ้ำ ไม่ตรงกัน รวมข้อมูลยาก |
| Hierarchical | โครงสร้างต้นไม้ | เป็นระเบียบ เหมาะกับลำดับชั้น | ความสัมพันธ์หลายต่อหลายลำบาก |
| Network | โครงสร้างใยแมงมุม | เชื่อมโยงได้หลายทาง | ซับซ้อน เขียน/ดูแลยาก |
| Relational | ตาราง + SQL | มาตรฐานดี ธุรกรรมแม่น | ขยายแบบกระจายยากในบางเคส |
| NoSQL | รูปแบบหลากหลาย | ยืดหยุ่น ขยายง่าย | มาตรฐานแตกต่าง ต้องออกแบบให้เหมาะงาน |
| Cloud-Native | DB เป็นบริการ | ดูแลง่าย ขยายตามโหลด | ต้องบริหารต้นทุน และความเสี่ยง vendor lock-in |
| AI Era | Vector/Real-time | ค้นหาความหมาย + ทันที | ต้องมี data governance และคุณภาพข้อมูลที่ดี |
Conclusion: ฐานข้อมูลไม่ได้เปลี่ยนเพราะ “เทคโนโลยีเท่” แต่เปลี่ยนเพราะโลกเปลี่ยน
ฐานข้อมูลวิวัฒนาการเพราะโจทย์ของโลกเปลี่ยนตลอดเวลา: จาก “เก็บให้เป็นระเบียบ” → “ค้นหาให้เร็ว” จาก “รองรับธุรกรรม” → “รองรับผู้ใช้มหาศาล” จาก “ข้อมูลตาราง” → “ข้อมูลหลากหลาย” จาก “ติดตั้งเอง” → “เป็นบริการบนคลาวด์” และตอนนี้จาก “ค้นหาด้วยคำ” → “ค้นหาด้วยความหมายเพื่อ AI”
สุดท้ายแล้ว ไม่มีฐานข้อมูลแบบเดียวที่ดีที่สุดสำหรับทุกงาน แต่การเข้าใจ “ประวัติและเหตุผลของแต่ละยุค” จะช่วยให้เราเลือกเทคโนโลยีได้อย่างมีเหตุผลมากขึ้น ไม่ใช่เลือกเพราะกระแส
คำถามชวนคิด: ถ้าคุณต้องออกแบบระบบวันนี้ คุณคิดว่าข้อมูลแบบไหนขององค์กรที่ “สำคัญที่สุด” และควรเก็บ/จัดการแบบไหนเพื่อให้พร้อมสำหรับอนาคต?
คำถามที่พบบ่อย (FAQ)
สเปรดชีตเหมาะกับงานส่วนบุคคลหรือทีมเล็ก ๆ แต่ฐานข้อมูลถูกออกแบบให้รองรับผู้ใช้หลายคนพร้อมกัน มีการควบคุมความถูกต้อง และจัดการความปลอดภัยได้เป็นระบบกว่า
ส่วนใหญ่ไม่ใช่ “แทน” แต่เป็น “เสริม” เพราะงานหลายอย่างยังเหมาะกับ Relational DB มาก เช่น ธุรกรรมการเงิน หรือระบบที่ต้องการความถูกต้องสูง
ไม่จำเป็น ถ้าองค์กรยังไม่ได้ทำงาน AI ที่ต้องค้นหาความหมาย แต่ถ้ากำลังทำระบบถามตอบเอกสาร หรือแนวทาง RAG มักจะเริ่มเห็นประโยชน์ชัดเจน